一、首页
软通华方以自主算力为基,以AI智能为翼,构建通用行业新一代AI算力资源管理平台。通过信创底座、AI算力调度与全流程开发工具的深度融合,全面释放数据与算力价值,助力各类机构迈向安全可信、智能驱动的AI时代。
二、详情页
当前,全球数字经济浪潮正以前所未有的速度重塑各行业的竞争格局。在中国,“十四五”规划深入实施、“信创”战略全面提速以及生成式人工智能(AIGC)爆发式增长的三重驱动下,AI应用转型已进入“深水区”。这不仅是技术的迭代,更是一场关乎国家安全、供应链自主与核心竞争力的深刻变革。
然而,机遇往往与挑战并存。随着AI转型的纵深推进,各类机构在AI算力资源管理层面正面临前所未有的复杂局面:
- 架构之变:底层硬件正从单一架构加速向“国产化多元异构”演进。海光、鲲鹏等国产CPU与昇腾、昆仑芯等国产GPU的引入,使得“混合架构”成为新常态,但也带来了资源调度难、软件适配繁、运维复杂度指数级上升的严峻挑战。
- 算力之需:业务重心从传统通用计算向“AI与大模型驱动”转移。百亿级参数模型的训练、实时推理任务,对算力的密度、存储的吞吐及部署的弹性提出了超越传统标准的全新要求。
- 安全之重:在“数据不出域”的监管红线与供应链不确定性的双重压力下,如何构建既自主可控又高性能的算力底座,成为各类机构必须回答的时代考题。
面对这一系列结构性难题,传统的“分散管理”或“单点工具”模式已难以为继。各行业亟需一种全栈式、场景化、可演进的新型解决方案——它不仅要能兼容复杂的异构环境,更要能将国产算力转化为实实在在的AI生产力。
软通华方,作为拥有深厚产业基因与全栈技术实力的数字化服务商,深刻洞察这一变革趋势。我们依托“全栈信创适配能力”与“软硬一体交付优势”,推出本套《AI算力资源管理平台解决方案》。从多芯兼容的资源池化策略,到本地化部署的大模型微调应用(如分布式训练环境),再到企业级智算中心的统筹规划,我们致力于帮助机构打破技术壁垒,化解合规焦虑,构建一个安全可信、弹性高效、面向未来的AI算力新底座。
本方案将深入剖析目标客户画像,直击当前痛点,并提供经过实战验证的解决路径与价值展望,旨在成为各类机构在AI转型关键时期的可靠行动指南。让我们携手,以自主可控之基,铸智能创新之魂。
第一章、客户痛点深度剖析
- 资源管理层面:异构环境带来的“调度黑洞”
- 兼容性噩梦:CPU从Intel/AMD转向海光(x86)、鲲鹏(ARM)等多架构并存;GPU从英伟达垄断转向引入昇腾、昆仑芯等国产卡。不同指令集、不同驱动版本导致软件适配工作量呈指数级增长。
- 资源调度困境:在“混合架构”下,如何统一调度异构算力?如何避免国产芯片性能未完全释放、英伟达资源闲置或过载?传统虚拟化和管理工具难以支撑。
- 扩展风险高:AI任务从单一环境迁移至多架构,面临代码重构、框架适配、环境兼容性等巨大技术挑战,稍有不慎影响业务连续性。
- 算力需求层面:AI爆发下的“供需失衡”
- 通用算力过剩,智能算力短缺:传统服务器库存积压,但能跑百亿参数大模型、支持分布式训练的AI服务器一机难求。
- 建设模式两难: 自建:投入大、周期长,且面临技术快速迭代导致的设备贬值风险。
- 租赁:虽然灵活,但机构受“数据不出域”监管限制,公有云租赁受限,私有化部署又缺乏弹性。 存储瓶颈:大模型训练需要海量数据的高吞吐、低延迟读取,传统存储架构成为算力发挥的瓶颈。
- 开发与安全层面:环境与数据的双重焦虑
- 环境构建繁琐:AI开发需要众多包依赖,环境隔离难,多人/多项目协作时易冲突,导致开发效率低下。
- 数据泄露隐患:数据孤岛现象严重,读取效率和安全性无法保障;引入外部大模型服务可能导致敏感数据外泄,不符合监管要求。
- 成果共享困难:模型开发缺乏统一管理,成果服务化繁琐,无法快速复用和沉淀能力。
第二章、针对性解决方案
- 全栈异构融合资源管理方案 —— 解决“调度黑洞”难题
多芯兼容测试与调优服务:
- 策略引导:基于软通华方全栈能力,提供“主推鲲鹏,兼容海光/飞腾”的咨询与实施服务。
- 实测验证:建立多架构兼容性测试实验室。针对客户主推芯片(如鲲鹏920或海光C86),进行OS、框架、算法库及应用的全链路压力测试与性能调优,输出《异构架构资源管理最佳实践报告》。
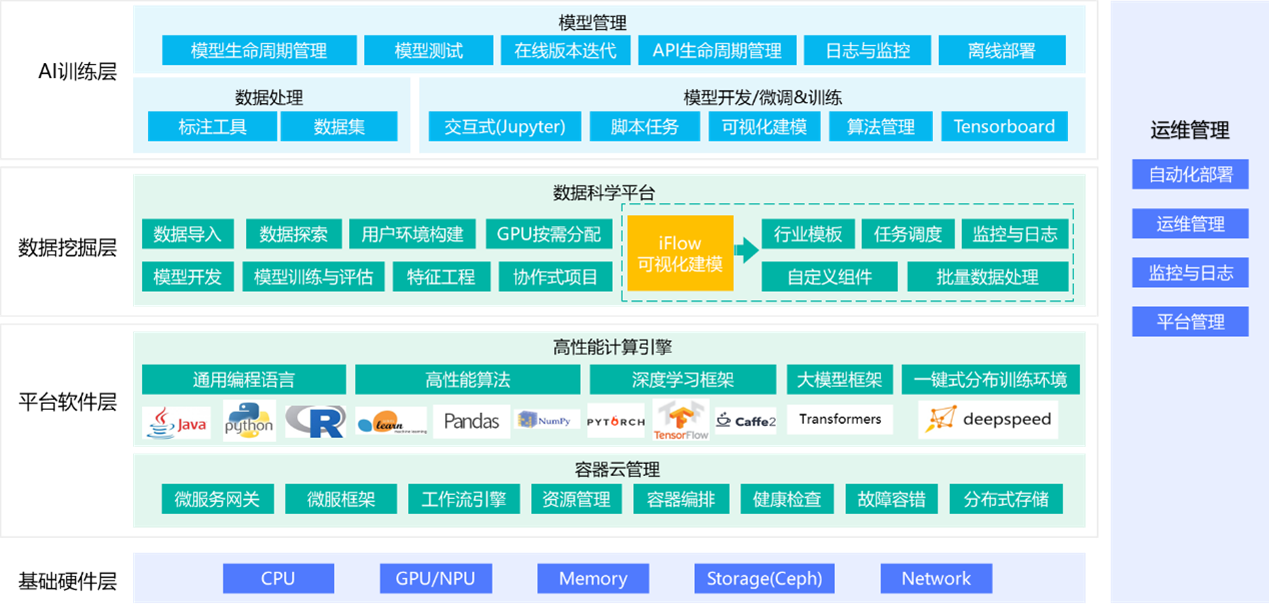
- 统一纳管平台:构建屏蔽底层硬件差异的资源调度层,实现x86、ARM、国产GPU的统一池化管理,智能分配任务至最适合的算力节点。支持细粒度资源模板设置、GPU虚拟化及标签功能,确保资源按需动态分配。
- 平滑扩展路径:提供从评估、适配、调度到验证的一站式服务,确保AI任务在国产底座上“稳如泰山”。
- AI算力引擎与开发平台方案 —— 解决“算力饥渴”与“开发效率”
高性能AI集群建设企业级AI算力平台:部署搭载华为昇腾910B等国产高端芯片的AI服务器集群,专为百亿级大模型训练、分布式任务设计。支持TensorFlow分布式、一键DeepSpeed环境准备,提高训练效率和可扩展性。
- 并行存储加速:配套大规模并行存储系统,满足训练数据TB级/s的高吞吐需求,消除IO瓶颈。支持数据统一管理、用户间隔离及AI数据集权限设置。
- 弹性混合部署:在“数据不出域”前提下,设计“本地核心训练 + 边缘推理”或“私有云为主 + 信创云为辅”的混合模式,平衡安全性与弹性。 软硬一体开发应用:多容器开发与大模型框架(标杆功能):
- 产品形态:基于软通华方容器云(Kubernetes+Docker) + 开箱即用环境(支持Python/R、100+算法库、TensorFlow/PyTorch等框架)。
- 核心功能: 交互式/终端化/虚拟桌面开发:支持Jupyter、SSH远程、GUI应用。 大模型微调:预置ChatGLM、LLaMA、Qwen等模型,支持Lora、P-Tuning、Freeze等方式,落地垂直行业应用(如法律问答、文档助理)。
- 可视化建模:拖拽式全流程(数据预处理、特征工程、模型评估),无需代码。 落地现状:已在多家机构进行测试验证,效果显著。
- 信创生态联合创新方案 —— 解决“好用”难题
- 联合适配中心:软通华方联合华为、智源研究院、清程极智等上下游厂商,建立AI信创联合实验室,提前解决应用层面的“卡点”。
- 场景化交付:不只卖平台,更交付“开箱即用”的场景包(如:大模型训练包、分布式任务加速包、镜像扩展包)。支持模型管理(版本迭代、RESTful API发布、离线部署)及标注工具(图像分类、目标检测、语义分割)。
第三章、收益与价值
|
维度
|
传统模式痛点
|
软通华方方案带来的额外收益
|
|
合规与安全
|
担心国产性能不足,依赖进口有断供风险
|
100% 自主可控:彻底消除供应链隐患,满足监管信创指标;数据零泄露:统一数据管理与隔离确保核心数据不出域。
|
|
运营效率
|
异构环境运维复杂,人工适配成本高
|
运维降本 40%+:统一纳管平台降低异构管理难度;开发效率提升 50%:开箱即用环境将构建时间从“天级”缩短至“分钟级”。
|
|
业务创新
|
算力不足制约AI模型迭代,创新落地慢
|
AI 加速引擎:预留弹性算力空间,支持大模型快速迭代;场景快速复制:经过验证的“微调框架”等应用可快速推广至全域。
|
|
投资保护
|
盲目采购导致设备闲置或快速贬值
|
精准投资:通过专业测试与咨询,避免买错芯片、配错架构;平滑演进:混合架构策略保护既有投资,逐步替换,降低TCO。
|
|
生态赋能
|
单打独斗,适配问题无人兜底
|
全栈兜底:软通华方作为总集成商,承担所有兼容性责任,让机构从“技术适配泥潭”中解脱,聚焦业务本身。
|
第四章、成功案例精选:国家级某研究所
- 客户背景
国家级某研究所是我国机器人技术与系统研究的核心机构,承担多项国家级智能机器人研发项目。随着AI模型复杂度提升,研究所面临GPU资源紧张、算力调度效率低下等问题,严重影响科研进度。
- 客户核心挑战
(1)算力不足制约AI业务发展:传统CPU服务器难以满足大规模模型训练和推理需求,AI算力瓶颈日益突出。
(2)国产化替代压力加大:信创替代进程持续推进,需要逐步构建基于国产CPU与AI芯片的自主可控算力体系。
(3)AI基础设施缺乏统一规划:AI服务器、数据平台和模型部署环境缺乏统一规划,资源调度效率低,运维复杂度高。
(4)数据安全与监管合规要求严格:涉及大量敏感数据,必须实现本地化部署与数据安全隔离,避免数据外流风险。
- 解决方案 针对该研究所的需求,软通华方为其规划并建设了AI算力资源管理平台,通过国产算力与开发工具融合,为AI应用提供稳定可靠的算力底座。 整体方案包括以下三个核心部分:
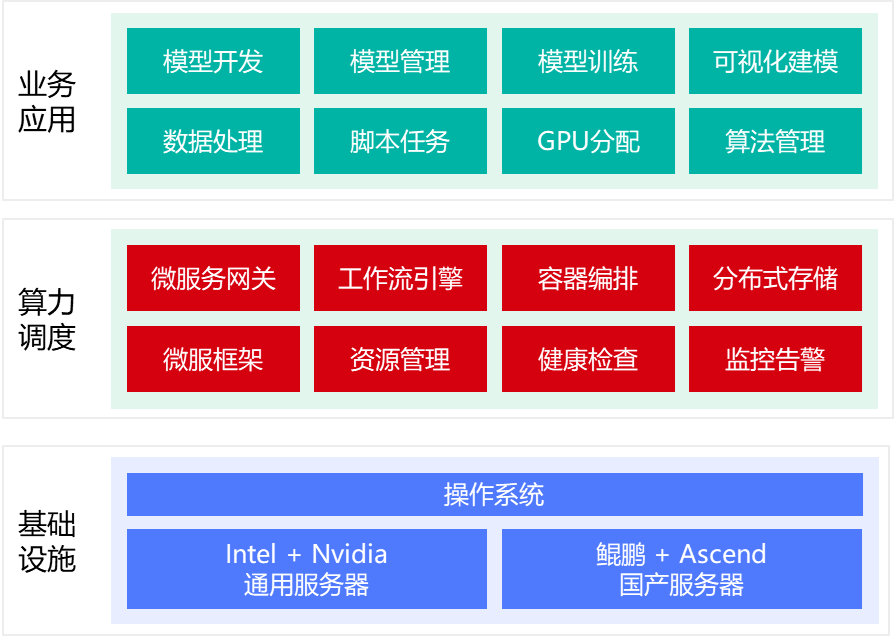
- 国产AI算力基础设施建设:部署基于昇腾910B AI芯片的高性能AI服务器集群,构建智能算力平台。核心配置包括:Atlas AI服务器(昇腾910B)、鲲鹏920多核CPU架构、高速NVMe SSD存储、100G/200G高速网络互联。通过高性能计算节点构建AI训练与推理集群,支持百亿参数规模模型训练及高并发推理任务。
- AI算力平台与大模型调度体系:在硬件算力平台基础上,构建统一的AI算力调度平台,实现:AI算力资源池化管理、大模型训练调度、AI开发与部署环境统一、GPU/NPU算力动态分配。通过平台化管理,使算力资源可以根据业务需求进行智能调度,提高资源利用率并降低运维复杂度。
- AI业务场景落地支持:平台建成后,研究所逐步在多个业务场景中部署AI应用,包括:智能机器人控制算法训练、强化学习模型优化、数据标注与预处理等。通过统一算力平台,能够快速部署新的AI应用,加速科技创新。
- 技术架构亮点
本项目在技术架构上具有以下特点: 国产化AI算力底座:采用鲲鹏 + 昇腾架构,实现国产算力平台的自主可控。 高性能AI训练能力:通过昇腾910B芯片构建高性能AI集群,支持大模型训练与推理。 高速网络互联:采用100G / 200G网络架构,满足AI训练高带宽需求。 分区式数据中心架构,整体算力平台划分为:管理服务区、通用计算区、AI计算存储区、外部接入区,实现资源隔离与安全管理。
- 项目实施成果:项目自2025年启动后,顺利完成咨询规划、架构设计及系统建设,并取得显著成果:
- 构建AI算力平台:建立国产化AI算力基础设施,为未来AI发展提供长期技术底座。
- 提升AI应用能力:为机器人算法训练、模型优化等核心业务提供稳定算力支撑。
- 降低IT运营成本:通过统一资源管理与自动化运维,提升算力资源利用率。
- 增强数据安全与合规能力:实现本地化AI部署,满足“数据不出域”的监管要求。
- 项目价值总结
国家级某研究所AI算力平台项目不仅解决了当前算力瓶颈问题,还为未来AI智能化奠定了坚实基础。项目带来的核心价值包括:
- 技术价值:构建国产AI算力平台、支撑AI创新应用、提升系统性能与稳定性。
- 业务价值:提升算法训练效率与精准度、优化模型开发体验、支持数据分析。
- 战略价值:实现AI科技自主可控、支撑长期数字化转型、打造AI算力标杆案例。
第五章、方案价值总结
本AI算力资源管理平台解决方案以自主可控、安全合规、智能算力、生态融合为核心设计理念,通过构建全栈信创算力底座与AI开发平台,帮助各类机构实现从传统IT架构向智能化AI基础设施的全面升级。
整体价值体现在四个维度:
- 构建自主可控的AI算力底座:通过国产CPU、AI芯片与信创软件生态的深度融合,打造安全可靠的计算平台。核心价值包括:支持鲲鹏 / 海光 / 飞腾 / x86多架构混合部署、支持昇腾 / 昆仑芯 / NVIDIA异构AI算力、实现统一资源池化与调度、降低供应链风险。从根本上解决“卡脖子技术”风险。
- 释放AI算力价值,推动业务创新:依托企业级AI算力平台,帮助机构快速部署和运行大模型应用。重点赋能核心业务场景:模型训练与微调、分布式任务调度、数据标注与预处理、模型评估与部署、算法优化与复用。实现算力 → 数据 → AI → 业务价值的转化闭环。
- 实现数据安全与监管合规:对数据安全要求极高,本方案通过本地化部署与分级数据管理,实现:数据不出域、本地化模型训练与推理、多级安全防护体系、符合信创及监管要求。保障核心数据资产安全。
- 降低IT复杂度与运维成本:通过统一算力调度平台与自动化运维体系,大幅降低IT架构复杂度。实现:异构资源统一管理、自动化运维、AI算力动态调度、IT资源利用率提升。整体IT运营效率提升30%–50%。



 公网安备11010802046207号
苏ICP备19012138号